Mehr Worker lösen genau ein Problem: zu wenig Durchsatz. Wächst Ihre Warteschlange schneller, als sie abgearbeitet wird, ist horizontales Skalieren die richtige Antwort. Braucht dagegen jede einzelne Aufgabe zu lange, verteilen zusätzliche Container nur dieselbe Wartezeit auf mehr Prozesse – die Serverrechnung steigt, der Durchsatz nicht.
Dieser Leitfaden klärt beides: welche Messwerte eine Skalierung auslösen dürfen, wie viele Worker Ihr Thread-Budget bei CaptchaAI trägt, und wie ein Auto-Scaler in Python sowie ein Docker-Scaler in Node.js Replikate anhand der Warteschlangentiefe hoch- und wieder herunterfahren – mit fester Obergrenze, damit eine Lastspitze nicht zum Kostenproblem wird.
Vertikal oder horizontal: die Vorentscheidung
Ein größerer Server hilft bei prozessgebundenen Engpässen: Bildvorverarbeitung, die einen CPU-Kern auslastet, oder mehrere Headless-Browser, die Arbeitsspeicher belegen. Horizontal skalieren Sie, wenn mehr Aufgaben gleichzeitig anstehen, als ein Prozess betreuen kann – der typische Fall bei CAPTCHA-Workloads, denn ein Worker wartet meist auf die API, statt zu rechnen.
Die Faustregel für die Diagnose: Beobachten Sie CPU und Arbeitsspeicher eines einzelnen Workers, während die Warteschlange wächst. Liegen beide Werte deutlich unter der Auslastungsgrenze, ist die Nebenläufigkeit der Engpass, nicht die Maschine – dann bringen zusätzliche Worker linearen Zuwachs, ein doppelt so großer Server fast nichts.
Wie viele Worker Ihr Thread-Budget trägt
CaptchaAI rechnet pro gleichzeitigem Thread ab, nicht pro Lösung: Ein Thread ist eine Aufgabe in Bearbeitung, danach nimmt derselbe Thread die nächste, und die Zahl der Lösungen pro Thread ist im Abrechnungsmonat nicht gedeckelt. Die Thread-Zahl Ihres Plans ist damit die Obergrenze der Parallelität – unabhängig davon, wie viele Container laufen. Zur Orientierung (Preise in US-Dollar): BASIC mit 5 Threads für 15 $/Monat, ADVANCE mit 50 Threads für 90 $/Monat, PREMIUM mit 100 Threads für 170 $/Monat.
Die nötige Worker-Zahl rechnen Sie vor dem Deployment aus: Worker = Spitzenaufgaben pro Minute × Lösungszeit in Sekunden / 60 / Aufgaben pro Worker. Bei 100 Aufgaben pro Minute, 30 Sekunden Lösungszeit und 10 gleichzeitigen Aufgaben je Worker ergibt das 100 × 30 / 60 / 10 = 5 Worker, die zusammen bis zu 50 Aufgaben offen halten. Der Plan braucht also mindestens 50 Threads, sonst laufen die zusätzlichen Worker in Fehlerantworten statt in Lösungen.
Signale, die eine Skalierung auslösen dürfen
Skalieren Sie nach Warteschlange und Fehlerbild. Fünf Messwerte reichen:
| Signal | Schwelle | Reaktion |
|---|---|---|
| Warteschlange wächst kontinuierlich | > 50 offene Aufgaben | Worker hinzufügen |
| Durchschnittliche Lösungslatenz | > 45 Sekunden | Worker hinzufügen – nicht die API ist der Engpass |
| CPU-Auslastung eines Workers | dauerhaft > 70 % | Worker hinzufügen statt Nebenläufigkeit pro Prozess erhöhen |
| Fehlerquote | > 5 % mit ERROR_NO_SLOT_AVAILABLE |
zu viele gleichzeitige Aufgaben – erst das Thread-Budget prüfen |
| Warteschlange leert sich zu langsam | < 80 % des Durchsatzziels | Worker hinzufügen oder Nebenläufigkeit anheben |
Architektur: Monitor, Scaler und Kostenbremse
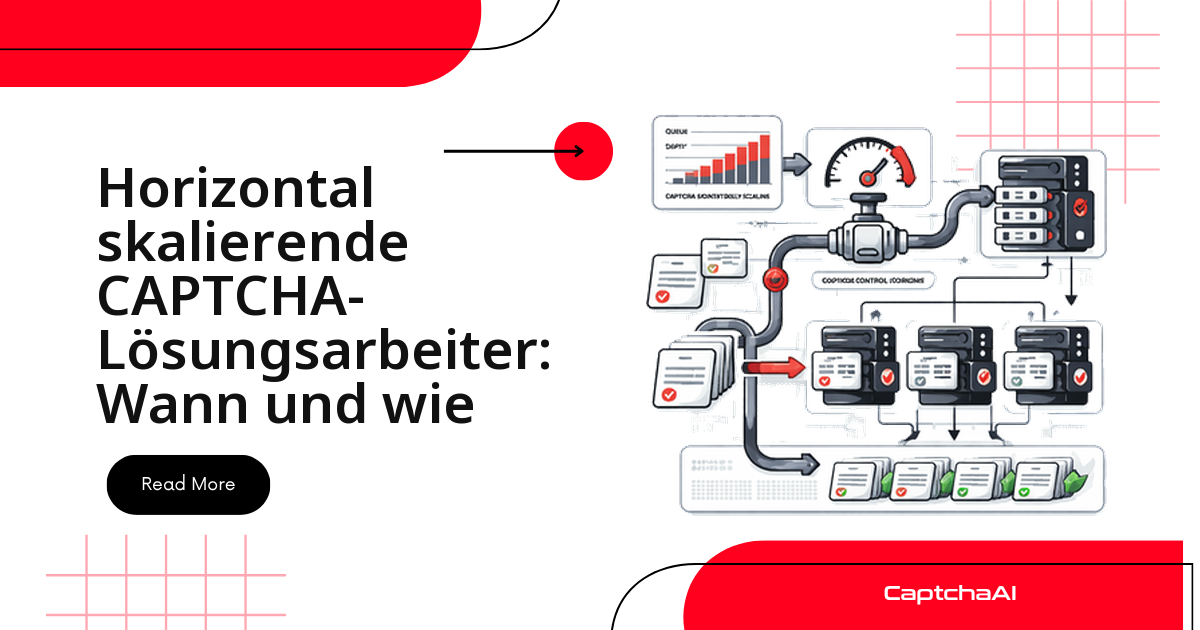
Drei Bausteine genügen: Ein Monitor beobachtet die Warteschlange, ein Scaler startet und beendet Worker, eine Kostenbremse deckelt die Flottengröße. Wichtig ist die Trennung – der Monitor entscheidet nichts, der Scaler misst nichts.
[Queue Monitor] ──watches──→ [Task Queue]
       │                         ↕
       │ scale signal       [Worker 1]
       ↓                    [Worker 2]
[Auto Scaler] ──adds──→    [Worker 3]
       │                    [Worker N...]
       ↓
[Cost Manager] ──caps──→ max workers
Auto-Scaling-Controller in Python
Der Controller kombiniert Warteschlangentiefe, geschätzte Abarbeitungsdauer und Fehlerquote. Steigt die Fehlerquote über 10 %, skaliert er bewusst nicht weiter hoch – mehr Last auf eine gestörte Strecke verschlimmert das Bild nur. Der Cooldown von 120 Sekunden verhindert das Pendeln.
import os
import time
import math
import threading
import subprocess
import requests

API_KEY = os.environ["CAPTCHAAI_API_KEY"]


class ScalingMetrics:
    """Collect metrics that drive scaling decisions."""

    def __init__(self):
        self.queue_depth = 0
        self.active_workers = 0
        self.tasks_per_minute = 0
        self.avg_solve_time = 30  # seconds
        self.error_rate = 0.0
        self.lock = threading.Lock()

    def update(self, queue_depth, active_workers, tasks_per_minute,
               avg_solve_time, error_rate):
        with self.lock:
            self.queue_depth = queue_depth
            self.active_workers = active_workers
            self.tasks_per_minute = tasks_per_minute
            self.avg_solve_time = avg_solve_time
            self.error_rate = error_rate

    @property
    def snapshot(self):
        with self.lock:
            return {
                "queue_depth": self.queue_depth,
                "active_workers": self.active_workers,
                "tasks_per_minute": self.tasks_per_minute,
                "avg_solve_time": self.avg_solve_time,
                "error_rate": self.error_rate,
            }


class HorizontalAutoScaler:
    def __init__(self, min_workers=2, max_workers=20,
                 tasks_per_worker=10, cooldown=120):
        self.min_workers = min_workers
        self.max_workers = max_workers
        self.tasks_per_worker = tasks_per_worker
        self.cooldown = cooldown
        self.current_workers = min_workers
        self.last_scale_time = 0
        self.metrics = ScalingMetrics()

    def calculate_desired_workers(self):
        snapshot = self.metrics.snapshot

        # Method 1: Queue-based scaling
        queue_based = math.ceil(
            snapshot["queue_depth"] / self.tasks_per_worker
        )

        # Method 2: Throughput-based scaling
        if snapshot["tasks_per_minute"] > 0 and snapshot["queue_depth"] > 0:
            drain_time = snapshot["queue_depth"] / snapshot["tasks_per_minute"]
            if drain_time > 5:  # More than 5 minutes to drain
                throughput_based = self.current_workers + 2
            else:
                throughput_based = self.current_workers
        else:
            throughput_based = self.current_workers

        # Method 3: Error-rate scaling (reduce if errors are high)
        if snapshot["error_rate"] > 0.1:
            error_based = max(
                self.min_workers,
                self.current_workers - 1
            )
        else:
            error_based = self.current_workers

        # Take the maximum of queue and throughput based, limited by error
        desired = max(queue_based, throughput_based)
        if snapshot["error_rate"] > 0.1:
            desired = min(desired, error_based)

        # Clamp to bounds
        return max(self.min_workers, min(self.max_workers, desired))

    def should_scale(self, desired):
        if desired == self.current_workers:
            return False
        if time.time() - self.last_scale_time < self.cooldown:
            return False
        return True

    def scale(self, desired):
        if not self.should_scale(desired):
            return

        direction = "up" if desired > self.current_workers else "down"
        diff = abs(desired - self.current_workers)

        print(f"Scaling {direction}: {self.current_workers} → {desired} "
              f"(+{diff if direction == 'up' else -diff})")

        if direction == "up":
            self._add_workers(diff)
        else:
            self._remove_workers(diff)

        self.current_workers = desired
        self.last_scale_time = time.time()

    def _add_workers(self, count):
        """Launch new worker containers."""
        for i in range(count):
            worker_id = f"captcha-worker-{self.current_workers + i}"
            # In production: use Docker API, K8s API, or cloud SDK
            print(f"  Launching {worker_id}")

    def _remove_workers(self, count):
        """Drain and stop workers."""
        for i in range(count):
            worker_id = f"captcha-worker-{self.current_workers - 1 - i}"
            print(f"  Draining and removing {worker_id}")

    def run_loop(self, interval=30):
        """Main auto-scaling loop."""
        print(f"Auto-scaler started: min={self.min_workers}, "
              f"max={self.max_workers}")
        while True:
            desired = self.calculate_desired_workers()
            self.scale(desired)

            snapshot = self.metrics.snapshot
            print(f"  Workers: {self.current_workers}, "
                  f"Queue: {snapshot['queue_depth']}, "
                  f"TPM: {snapshot['tasks_per_minute']}, "
                  f"Errors: {snapshot['error_rate']:.1%}")
            time.sleep(interval)


# Start auto-scaler
scaler = HorizontalAutoScaler(
    min_workers=2,
    max_workers=20,
    tasks_per_worker=10,
    cooldown=120  # 2-minute cooldown between scaling
)

# Run in background
scaling_thread = threading.Thread(target=scaler.run_loop, daemon=True)
scaling_thread.start()
Docker-Replikate mit Node.js steuern
Ohne Kubernetes kommt man mit Docker Compose weit: docker compose up -d --scale ändert die Replikatzahl im laufenden Betrieb, ohne bestehende Container neu zu erstellen. Der Scaler unten arbeitet mit Hysterese – hoch ab 50 offenen Aufgaben, herunter erst unter 10 – bei gleichem Cooldown.
const { exec } = require("child_process");
const { promisify } = require("util");
const execAsync = promisify(exec);

class DockerHorizontalScaler {
  constructor(options = {}) {
    this.serviceName = options.serviceName || "captcha-worker";
    this.minReplicas = options.minReplicas || 2;
    this.maxReplicas = options.maxReplicas || 15;
    this.currentReplicas = this.minReplicas;
    this.scaleUpThreshold = options.scaleUpThreshold || 50;
    this.scaleDownThreshold = options.scaleDownThreshold || 10;
    this.cooldownMs = options.cooldownMs || 120000;
    this.lastScaleTime = 0;
  }

  async evaluate(metrics) {
    const now = Date.now();
    if (now - this.lastScaleTime < this.cooldownMs) {
      return { action: "cooldown", current: this.currentReplicas };
    }

    let desired = this.currentReplicas;

    // Scale up: queue growing
    if (metrics.queueDepth > this.scaleUpThreshold) {
      const needed = Math.ceil(metrics.queueDepth / 10);
      desired = Math.min(this.maxReplicas, Math.max(desired, needed));
    }

    // Scale down: queue mostly empty
    if (
      metrics.queueDepth < this.scaleDownThreshold &&
      this.currentReplicas > this.minReplicas
    ) {
      desired = Math.max(this.minReplicas, this.currentReplicas - 1);
    }

    if (desired !== this.currentReplicas) {
      await this.scaleTo(desired);
      return { action: "scaled", from: this.currentReplicas, to: desired };
    }

    return { action: "no_change", current: this.currentReplicas };
  }

  async scaleTo(replicas) {
    const clamped = Math.max(
      this.minReplicas,
      Math.min(this.maxReplicas, replicas)
    );

    console.log(`Scaling ${this.serviceName}: ${this.currentReplicas} → ${clamped}`);

    try {
      // Docker Compose scaling
      await execAsync(
        `docker compose up -d --scale ${this.serviceName}=${clamped} --no-recreate`
      );
      this.currentReplicas = clamped;
      this.lastScaleTime = Date.now();
    } catch (err) {
      console.error(`Scale failed: ${err.message}`);
    }
  }

  status() {
    return {
      service: this.serviceName,
      current: this.currentReplicas,
      min: this.minReplicas,
      max: this.maxReplicas,
      lastScale: new Date(this.lastScaleTime).toISOString(),
    };
  }
}

// Monitor loop
const scaler = new DockerHorizontalScaler({
  serviceName: "captcha-worker",
  minReplicas: 2,
  maxReplicas: 15,
  cooldownMs: 120000,
});

async function monitorAndScale() {
  // In production, fetch from your queue/monitoring system
  const metrics = {
    queueDepth: 75, // Example
    errorRate: 0.02,
    avgSolveTime: 25,
  };

  const result = await scaler.evaluate(metrics);
  console.log("Scale decision:", result);
  console.log("Status:", scaler.status());
}

setInterval(monitorAndScale, 30000);
Die Kostenbremse gehört in den Scaler
Eine Obergrenze in Worker-Zahlen ist gut, eine in Geld ist besser. Die abgeleitete Klasse deckelt die Flotte über ein Stundenbudget: Bei 0,05 $ je Worker-Stunde und 2,00 $ pro Stunde laufen höchstens 40 Worker, egal was die Warteschlange fordert. Gemeint sind die Kosten Ihrer eigenen Infrastruktur – die CaptchaAI-Seite bleibt der feste Monatspreis des Plans.
class CostAwareScaler(HorizontalAutoScaler):
    def __init__(self, hourly_cost_per_worker=0.05, budget_per_hour=2.0,
                 **kwargs):
        super().__init__(**kwargs)
        self.hourly_cost = hourly_cost_per_worker
        self.budget = budget_per_hour

    def calculate_desired_workers(self):
        desired = super().calculate_desired_workers()

        # Cap by budget
        max_affordable = int(self.budget / self.hourly_cost)
        if desired > max_affordable:
            print(f"  Budget cap: wanted {desired}, "
                  f"can afford {max_affordable}")
            desired = max_affordable

        return desired
Praxisbeispiel: das nächtliche Zeitfenster
Ein Team in Berlin gleicht nachts Produktdaten der eigenen Shopware-Instanzen ab. Tagsüber genügen zwei Worker auf einem kleinen VPS bei Hetzner; zwischen 2 und 5 Uhr stapeln sich rund 1.200 Aufgaben, weil die GitLab-CI-Jobs aller Standorte gleichzeitig starten. Statt die Flotte dauerhaft auf Spitzenlast auszulegen, übernimmt der Scaler dieses Zeitfenster: hoch bis an das Thread-Budget, nach dem Leerlaufen zurück auf zwei.
Ein DACH-typischer Zusatzpunkt: Prüfen Sie, was Ihre Worker protokollieren. IP-Adressen und Session-Kennungen gelten in der DSGVO als personenbezogene Daten – ein Log, das mit jedem Skalierungsereignis mitwächst, wird schnell zum Aufbewahrungsproblem.
Checkliste vor dem Hochskalieren
| Bereich | Worauf es ankommt |
|---|---|
| Warteschlange | persistent (Redis, SQS) – niemals nur im Arbeitsspeicher |
| Worker | zustandslos: jeder Worker kann jede Aufgabe übernehmen |
| Health-Checks | der Load Balancer erkennt, welche Worker tatsächlich arbeiten |
| Draining | laufende Aufgaben zu Ende führen, bevor ein Container stoppt |
| Monitoring | Warteschlangentiefe, Latenz und Fehlerquote sind sichtbar |
| Threads | die Plan-Threads begrenzen die Parallelität, nicht die Container-Zahl |
| Kosten | max_workers und Stundenbudget sind gesetzt |
Typische Fehlerbilder beim Skalieren
| Symptom | Ursache | Vorgehen |
|---|---|---|
| Scaler pendelt im Minutentakt | Schwellen liegen zu eng beieinander | Hysterese: hoch ab 50, herunter unter 10; Cooldown ≥ 120 Sekunden |
| Neue Worker bringen keinen Durchsatz | Thread-Budget ausgereizt, nicht die Rechenleistung | Anteil ERROR_NO_SLOT_AVAILABLE messen, Nebenläufigkeit senken oder Plan-Threads erhöhen |
| Frische Worker laufen leer | Warteschlange war vor dem Start bereits abgearbeitet | Cooldown verkürzen, in kleineren Schritten skalieren |
| Kosten steigen sprunghaft | keine Obergrenze im Scaler | max_workers und Budgetgrenze setzen, Alarm auf die Flottengröße legen |
| Fehlerquote steigt nach dem Rollout | neue Version ändert Retry- oder Session-Verhalten | Läufe vor und nach dem Deployment vergleichen, im Zweifel zurückrollen |
Häufige Fragen
Was bedeutet ERROR_NO_SLOT_AVAILABLE beim Hochskalieren?
Es sind mehr Aufgaben gleichzeitig offen, als der Plan Threads bereitstellt – ein Kapazitäts-, kein Infrastruktursignal. Weitere Container beheben ihn nicht; senken Sie die Nebenläufigkeit pro Worker oder erhöhen Sie das Thread-Budget.
Wie verhindere ich, dass der Scaler ständig hin- und herschaltet?
Mit zwei getrennten Schwellen und einem Cooldown: hoch ab 50 offenen Aufgaben, herunter erst unter 10, dazwischen mindestens 120 Sekunden Ruhe. Ohne diese Hysterese reagiert der Scaler auf normale Schwankungen.
Müssen CAPTCHA-Worker wirklich zustandslos sein?
Ja, sonst funktioniert horizontales Skalieren nicht sauber: Jeder Worker muss jede Aufgabe aus der gemeinsamen Warteschlange übernehmen können. Aufgabenstatus, Zwischenergebnisse und Zähler gehören deshalb nach Redis oder in die Datenbank, nicht in den Prozessspeicher.
Lohnt sich Autoscaling auch bei gleichmäßiger Last?
Selten. Bei konstantem Volumen ist eine feste Worker-Zahl einfacher zu betreiben. Autoscaling lohnt sich, wenn Spitzen und Ruhephasen um den Faktor drei oder mehr auseinanderliegen – Nachtläufe, Kampagnenwochen, saisonale Peaks.
Nächste Schritte
Rechnen Sie zuerst das Thread-Budget, setzen Sie dann Ober- und Untergrenze im Scaler, und schalten Sie die Automatik erst danach scharf. Den API-Schlüssel dafür erhalten Sie auf captchaai.com.