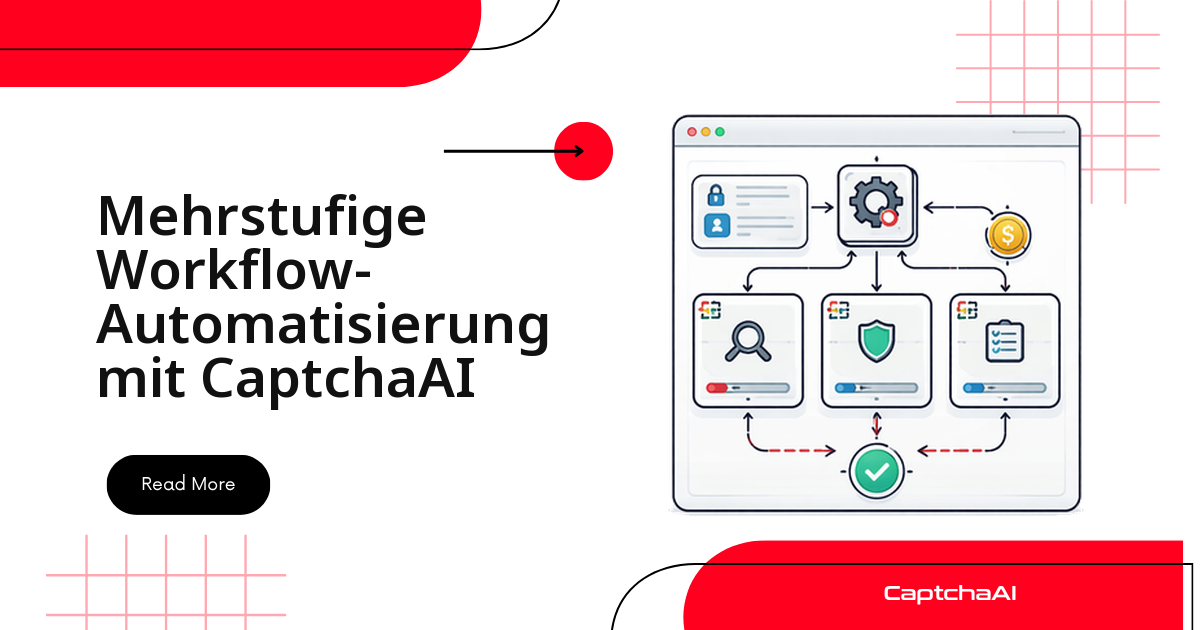
Mehrstufige Automatisierungen scheitern selten am Datenexport – sie scheitern an Schritt 1. Die Anmeldemaske zeigt ein reCAPTCHA v2 oder ein Cloudflare Turnstile, und alles Weitere läuft ins Leere. Die Antwort ist keine Sonderbehandlung für CAPTCHAs, sondern eine Pipeline, in der das Lösen ein normaler Schritt neben Sitzung, Aktion und Export ist.
Dieser Leitfaden zeigt den Aufbau in Python: Registry für Zugangsdaten, Sitzungsverwaltung für Cookies und Proxys, Lösungsschritt über die CaptchaAI-API, Executor für den parallelen Lauf. Voraussetzung: Sie sind für die angesprochenen Systeme autorisiert – eigene Mandanten, eigene Marken-Accounts, eigene Staging-Umgebungen.
Warum der Anmeldeschritt die ganze Kette blockiert
Bei einer einzelnen Abfrage ist ein fehlgeschlagenes CAPTCHA ein verlorener Request. In einer Kette ist es ein verlorener Zustand: Sitzung halb aufgebaut, Cookie-Set unvollständig, Job in der Mitte stehen geblieben. Drei Konsequenzen prägen das Design.
- Zustand persistieren statt neu erzeugen. Wer nach jedem Fehler von vorn anmeldet, erzeugt bei jedem Lauf neue CAPTCHA-Abfragen.
- Eigenes Timeout für den Lösungsschritt. CaptchaAI löst reCAPTCHA v2 in unter 60 Sekunden, Cloudflare Turnstile in unter 10 Sekunden – die Wiederholungslogik darf nicht früher abbrechen.
- Tokens sind kurzlebig. Lösen Sie unmittelbar vor dem Absenden, nicht Minuten vorher auf Vorrat.
Wofür sich mehrstufige Automatisierung lohnt
| Szenario | Konkreter Ablauf |
|---|---|
| Agenturbetrieb | Beiträge über betreute Marken-Accounts pflegen |
| Shop-Operations | Preise und Bestände in mehreren Shopware- oder JTL-Mandanten pflegen |
| Datenerhebung | Reports aus Portalen mit eigenem Zugang ziehen |
| QA-Läufe | Anmeldeflüsse mit Test-Accounts verschiedener Rollen prüfen |
| Betriebsüberwachung | Kontostatus, Guthaben und Benachrichtigungen nächtlich abfragen |
Architektur der Workflow-Pipeline: vier Bausteine
Der Ablauf gliedert sich in vier getrennte Verantwortlichkeiten:
┌────────────────┐     ┌──────────────┐     ┌───────────┐     ┌───────────────┐
│ Account        │────▶│ Session      │────▶│ CAPTCHA   │────▶│ Workflow      │
│ Registry       │     │ Manager      │     │ Solver    │     │ Executor      │
│ (credentials)  │     │ (cookies,    │     │           │     │ (per-account  │
│                │     │  proxies)    │     │           │     │  actions)     │
└────────────────┘     └──────────────┘     └───────────┘     └───────────────┘
Jeder Baustein kennt nur seine eigene Aufgabe. So lässt sich später ein zweiter CAPTCHA-Typ ergänzen, ohne den Rest anzufassen.
Die Bausteine im Code
Registry: Zugangsdaten und Zustand an einer Stelle
Die Registry hält je Zugang Plattform, Anmeldedaten, optionalen Proxy, Cookies und den Zeitpunkt der letzten Anmeldung. Der Status (active, login_failed) zeigt, welche Einträge aus dem Lauf fallen.
import json
from dataclasses import dataclass, field, asdict
from typing import Optional


@dataclass
class Account:
    id: str
    platform: str
    username: str
    password: str
    proxy: Optional[str] = None
    cookies: dict = field(default_factory=dict)
    last_login: Optional[float] = None
    status: str = "active"


class AccountRegistry:
    def __init__(self, filepath="accounts.json"):
        self.filepath = filepath
        self.accounts = {}
        self._load()

    def _load(self):
        try:
            with open(self.filepath, "r") as f:
                data = json.load(f)
                for item in data:
                    acct = Account(**item)
                    self.accounts[acct.id] = acct
        except FileNotFoundError:
            pass

    def save(self):
        data = [asdict(a) for a in self.accounts.values()]
        with open(self.filepath, "w") as f:
            json.dump(data, f, indent=2)

    def add(self, account):
        self.accounts[account.id] = account
        self.save()

    def get(self, account_id):
        return self.accounts.get(account_id)

    def get_by_platform(self, platform):
        return [a for a in self.accounts.values() if a.platform == platform and a.status == "active"]

    def update_status(self, account_id, status):
        if account_id in self.accounts:
            self.accounts[account_id].status = status
            self.save()
Sitzungsverwaltung: Cookies und Proxys je Zugang
Der Sitzungsmanager macht jeden weiteren Lauf billiger als den ersten: Gültige Cookies werden auf die Platte geschrieben und beim Start wieder eingelesen. Ein hinterlegter proxy gilt nur für diese eine Sitzung.
import time
import requests
import pickle
import os


class SessionManager:
    def __init__(self, sessions_dir="sessions"):
        self.sessions_dir = sessions_dir
        os.makedirs(sessions_dir, exist_ok=True)
        self.sessions = {}

    def get_session(self, account):
        """Get or create a requests session for an account."""
        if account.id in self.sessions:
            return self.sessions[account.id]

        session = requests.Session()

        # Set proxy if configured
        if account.proxy:
            session.proxies = {
                "http": account.proxy,
                "https": account.proxy,
            }

        # Load saved cookies
        cookie_file = os.path.join(self.sessions_dir, f"{account.id}.cookies")
        if os.path.exists(cookie_file):
            with open(cookie_file, "rb") as f:
                session.cookies = pickle.load(f)

        self.sessions[account.id] = session
        return session

    def save_session(self, account):
        """Persist session cookies."""
        if account.id in self.sessions:
            cookie_file = os.path.join(self.sessions_dir, f"{account.id}.cookies")
            with open(cookie_file, "wb") as f:
                pickle.dump(self.sessions[account.id].cookies, f)

    def clear_session(self, account_id):
        if account_id in self.sessions:
            del self.sessions[account_id]
        cookie_file = os.path.join(self.sessions_dir, f"{account_id}.cookies")
        if os.path.exists(cookie_file):
            os.remove(cookie_file)
Anmeldung mit automatischer CAPTCHA-Lösung
Hier laufen zwei Dinge zusammen: Der CaptchaSolver übermittelt die Abfrage an in.php und fragt das Ergebnis über res.php ab; der LoginHandler holt zuerst die Anmeldeseite (CSRF-Token, Startcookies), trägt das Token in das Formularfeld ein und sendet ab. reCAPTCHA v2 nutzt die Methode userrecaptcha mit googlekey, Cloudflare Turnstile die Methode turnstile mit sitekey; das Zielfeld steuert captcha_field.
import time
import requests


class CaptchaSolver:
    BASE = "https://ocr.captchaai.com"

    def __init__(self, api_key):
        self.api_key = api_key

    def solve(self, params, initial_wait=10):
        params["key"] = self.api_key
        params["json"] = 1
        resp = requests.post(f"{self.BASE}/in.php", data=params).json()
        if resp["status"] != 1:
            raise Exception(resp["request"])
        task_id = resp["request"]
        time.sleep(initial_wait)
        for _ in range(60):
            result = requests.get(
                f"{self.BASE}/res.php",
                params={"key": self.api_key, "action": "get", "id": task_id, "json": 1},
            ).json()
            if result["request"] == "CAPCHA_NOT_READY":
                time.sleep(5)
                continue
            if result["status"] == 1:
                return result["request"]
            raise Exception(result["request"])
        raise TimeoutError("Timed out")


class LoginHandler:
    def __init__(self, captcha_solver):
        self.solver = captcha_solver

    def login(self, session, account, login_config):
        """
        login_config: {
            "url": login page URL,
            "submit_url": login form action URL,
            "captcha_type": "recaptcha_v2" | "turnstile" | None,
            "sitekey": "...",
            "username_field": "username",
            "password_field": "password",
            "captcha_field": "g-recaptcha-response",
        }
        """
        # Get login page (for CSRF token / cookies)
        session.get(login_config["url"])

        payload = {
            login_config.get("username_field", "username"): account.username,
            login_config.get("password_field", "password"): account.password,
        }

        # Solve CAPTCHA if present
        captcha_type = login_config.get("captcha_type")
        if captcha_type:
            if captcha_type == "recaptcha_v2":
                token = self.solver.solve({
                    "method": "userrecaptcha",
                    "googlekey": login_config["sitekey"],
                    "pageurl": login_config["url"],
                })
            elif captcha_type == "turnstile":
                token = self.solver.solve({
                    "method": "turnstile",
                    "sitekey": login_config["sitekey"],
                    "pageurl": login_config["url"],
                })
            else:
                raise ValueError(f"Unknown captcha type: {captcha_type}")

            captcha_field = login_config.get("captcha_field", "g-recaptcha-response")
            payload[captcha_field] = token

        submit_url = login_config.get("submit_url", login_config["url"])
        resp = session.post(submit_url, data=payload, allow_redirects=True)

        # Check login success
        success = resp.status_code == 200 and "login" not in resp.url.lower()
        if success:
            account.last_login = time.time()
        return success
Executor: derselbe Ablauf über einen Thread-Pool
Der Executor klammert alles zusammen: Anmeldung nur, wenn die letzte älter als eine Stunde ist, danach die Workflow-Funktion, Fehler je Zugang abgefangen. max_workers begrenzt die Parallelität – und bestimmt die Tarifwahl.
import time
import logging
from concurrent.futures import ThreadPoolExecutor, as_completed

logger = logging.getLogger("workflow")


class WorkflowExecutor:
    def __init__(self, api_key, max_workers=5):
        self.solver = CaptchaSolver(api_key)
        self.registry = AccountRegistry()
        self.sessions = SessionManager()
        self.login_handler = LoginHandler(self.solver)
        self.max_workers = max_workers

    def run_for_account(self, account, workflow_fn, login_config):
        """Execute a workflow for a single account."""
        session = self.sessions.get_session(account)

        # Login if needed
        if not account.last_login or time.time() - account.last_login > 3600:
            logger.info(f"Logging in: {account.id}")
            if not self.login_handler.login(session, account, login_config):
                logger.error(f"Login failed: {account.id}")
                self.registry.update_status(account.id, "login_failed")
                return {"account": account.id, "status": "login_failed"}

            self.sessions.save_session(account)
            self.registry.save()

        # Execute workflow
        try:
            result = workflow_fn(session, account)
            return {"account": account.id, "status": "success", "data": result}
        except Exception as e:
            logger.error(f"Workflow failed for {account.id}: {e}")
            return {"account": account.id, "status": "error", "error": str(e)}

    def run_for_all(self, platform, workflow_fn, login_config):
        """Execute a workflow across all accounts on a platform."""
        accounts = self.registry.get_by_platform(platform)
        results = []

        with ThreadPoolExecutor(max_workers=self.max_workers) as pool:
            futures = {
                pool.submit(self.run_for_account, acct, workflow_fn, login_config): acct
                for acct in accounts
            }
            for future in as_completed(futures):
                result = future.result()
                results.append(result)
                logger.info(f"  {result['account']}: {result['status']}")

        return results
Vollständiges Beispiel: Benachrichtigungen prüfen
Das Skript konfiguriert die Anmeldung einmal und lässt den Workflow über alle aktiven Zugänge laufen. YOUR_API_KEY ersetzen Sie durch Ihren Schlüssel aus dem Dashboard.
executor = WorkflowExecutor("YOUR_API_KEY", max_workers=3)

# Define platform login config
login_config = {
    "url": "https://platform.example.com/login",
    "submit_url": "https://platform.example.com/api/login",
    "captcha_type": "recaptcha_v2",
    "sitekey": "6Le-wvkSAAAA...",
    "username_field": "email",
    "password_field": "password",
    "captcha_field": "g-recaptcha-response",
}


# Define workflow
def check_notifications(session, account):
    resp = session.get("https://platform.example.com/api/notifications")
    data = resp.json()
    return {
        "unread": data.get("unread_count", 0),
        "latest": data.get("notifications", [])[:5],
    }


# Run across all accounts
results = executor.run_for_all("example_platform", check_notifications, login_config)

for r in results:
    if r["status"] == "success":
        print(f"{r['account']}: {r['data']['unread']} unread notifications")
    else:
        print(f"{r['account']}: {r['status']}")
Weitere Schritte für dieselbe Pipeline
Ein Workflow ist hier nur eine Funktion mit der Signatur (session, account). Die Pipeline wächst, ohne dass Anmelde- oder Sitzungslogik angefasst wird.
Daten exportieren
def export_data(session, account):
    resp = session.get("https://platform.example.com/api/export")
    filename = f"export_{account.id}.json"
    with open(filename, "w") as f:
        f.write(resp.text)
    return {"file": filename, "size": len(resp.text)}
Status abfragen
def check_status(session, account):
    resp = session.get("https://platform.example.com/api/account/status")
    return resp.json()
Einstellungen schreiben
def update_settings(session, account):
    resp = session.post(
        "https://platform.example.com/api/settings",
        json={"timezone": "UTC", "notifications": True},
    )
    return {"updated": resp.status_code == 200}
Von max_workers zur richtigen Tarifstufe
max_workers bestimmt, wie viele CAPTCHA-Abfragen gleichzeitig offen sind – und genau darauf bezieht sich die Abrechnung: CaptchaAI rechnet pro gleichzeitigem Thread ab, nicht pro Lösung; die Zahl der Lösungen je Thread ist unbegrenzt.
| Tarifstufe | Preis/Monat | Threads | Typischer Einsatz |
|---|---|---|---|
| BASIC | 15 $ | 5 | Ein Mandant, nächtlicher Lauf |
| STANDARD | 30 $ | 15 | Agenturbetrieb mit mehreren Marken-Accounts |
| ADVANCE | 90 $ | 50 | Parallele Workflows über mehrere Plattformen |
| PREMIUM | 170 $ | 100 | Dauerbetrieb mit kurzen Intervallen |
Darüber liegen CORPORATE (240 $ für 150 Threads), ENTERPRISE (300 $ für 200 Threads) sowie VIP-1 (1.500 $ für 1.000 Threads), VIP-2 (4.500 $ für 3.000 Threads) und VIP-3 (7.500 $ für 5.000 Threads). Alle Preise in US-Dollar.
Faustregel: max_workers nie höher setzen als die Thread-Zahl Ihrer Stufe. Ein nächtlicher Lauf über 40 Zugänge mit max_workers=5 braucht kein größeres Kontingent – er dauert nur länger. Taktgeber ist die Lösungszeit: unter 10 Sekunden bei Cloudflare Turnstile, unter 60 Sekunden bei reCAPTCHA v2, jeweils mit hoher Erfolgsquote auf den unterstützten Typen.
Betrieb im DACH-Umfeld: Zeitplan, Hosting, Datenschutz
Für den produktiven Betrieb hat sich dieses Muster bewährt:
- Zeitplanung über die vorhandene CI. Ein
schedule-Job in GitLab CI oder GitHub Actions genügt. Der API-Schlüssel gehört in maskierte CI-Variablen, nie ins Repository. - Kleiner Worker genügt. Ein VPS bei Hetzner, IONOS oder netcup reicht aus; der Lösungsschritt läuft ohnehin auf der CaptchaAI-Seite.
- DSGVO-Blick auf die Datenflüsse. IP-Adressen und Anmeldedaten sind personenbezogene Daten. Prüfen Sie, welche Felder Ihr Export enthält, wie lange Cookie-Dateien in
sessions/liegen und ob eine Rechtsgrundlage dokumentiert ist – Sorgfaltspflicht auf Ihrer Seite, keine Zusage des Dienstes. - Zugriffsrahmen festhalten. Anmeldungen nur auf eigenen oder freigegebenen Systemen; die AGB der Plattform sind die Grenze.
Fehlerbehebung
| Problem | Ursache | Lösung |
|---|---|---|
| Alle Anmeldungen scheitern | Sitekey ausgetauscht | Sitekey neu aus dem Quelltext auslesen |
| Sitzung nicht akzeptiert | Cookies abgelaufen | Sitzung löschen, neu anmelden |
| Antwort 429 | Zu viele gleichzeitige Anmeldungen | max_workers senken, Wartezeit einbauen |
| Zugang gesperrt | Zu viele Fehlversuche | Anmeldedaten prüfen, Intervall verlängern |
ERROR_CAPTCHA_UNSOLVABLE |
Falscher Sitekey oder falsche Page-URL | Beide Werte gegen die geladene Seite abgleichen |
Häufige Fragen
Welche CAPTCHA-Typen deckt der Anmeldeschritt ab?
Die im Login üblichen: reCAPTCHA v2 inklusive Invisible und Enterprise, reCAPTCHA v3, Cloudflare Turnstile und Cloudflare Challenge, GeeTest v3 sowie Bild-, Raster- und BLS-CAPTCHAs. Hinzu kommen CaptchaFox (Beta), Friendly Captcha (Beta) und Lemin (Beta). Nicht unterstützt werden hCaptcha und FunCaptcha, GeeTest v4 ist nur als „bald verfügbar“ angekündigt. Weitere Typen ergänzen Sie im LoginHandler mit der jeweiligen method.
Was passiert, wenn das Token abläuft, bevor das Formular abgesendet wird?
Das Zielsystem verwirft die Anmeldung, und der Workflow bricht mit einem scheinbaren Passwortfehler ab. CAPTCHA-Tokens sind nur rund zwei Minuten gültig. Lösen Sie deshalb direkt vor dem session.post(...), nicht schon beim Aufbau der Warteschlange.
Wie lange dauert ein Lauf über 50 Zugänge?
Das hängt fast ausschließlich vom Anmeldeanteil ab. Mit persistierten Cookies besteht der Lauf nur aus HTTP-Anfragen – Minuten statt Stunden. Ohne gültige Sitzungen fällt je Zugang ein CAPTCHA an; bei max_workers=5 und reCAPTCHA v2 sind das rund zehn Wellen von jeweils bis zu 60 Sekunden.
Wie halte ich Zugangsdaten aus dem Repository heraus?
Über Umgebungsvariablen oder einen Secrets-Manager wie Vault oder den GitLab-CI-Variablenspeicher. Die Datei accounts.json gehört in .gitignore; laden Sie Benutzername und Passwort beim Start in die Account-Objekte.
Lässt sich die Pipeline unbeaufsichtigt betreiben?
Ja, sofern drei Dinge protokolliert werden: Ergebnisstatus je Zugang, Zahl der gelösten CAPTCHAs und das verbleibende Guthaben im Dashboard. Als Alarmkriterium genügt meist der Abgleich der Statusverteilung mit dem Vortag.
Verwandte Leitfäden
Den CAPTCHA-Schritt aus Ihrer Pipeline nehmen – mit CaptchaAI lösen.